一、前言
彼岸图网 是一个很好的收集壁纸的网站,壁纸高清,我很喜欢,并且还赞助了会员。这次的爬取对象就是它了。
这次的流程是先写爬虫脚本,然后放在VPS上爬取地址,最后用COLAB下载。
二、网站分析与确定爬取流程
分析网页网址
比如,我想爬取 风景 类的壁纸,先进入风景专区,然后点击一张图片的地址,发现此时的图片预览图是原图!!!那就可以确定爬取流程了。先以一张图为例。
1.1 找到图片分类网址
http://www.netbian.com/fengjing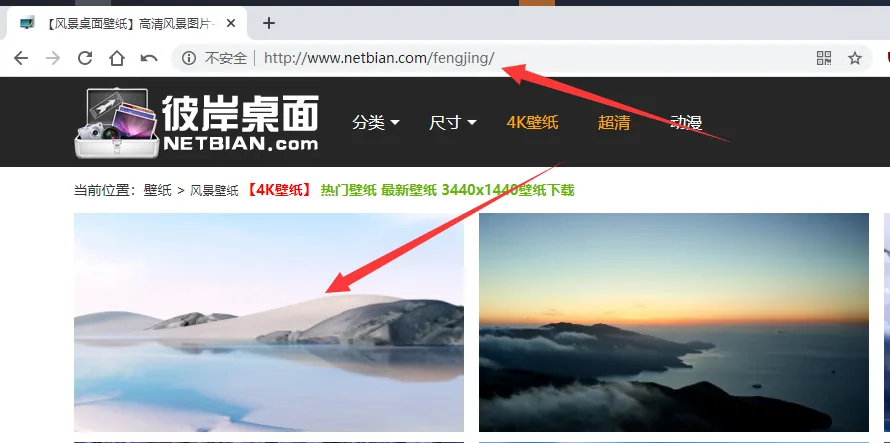
1.2 找到图片介绍地址和真实地址
图片介绍地址:
http://www.netbian.com/desk/23006.htm图片真实地址:
http://img.netbian.com/file/2020/1108/1da1eab002604a8adcc33d8103b5758d.jpg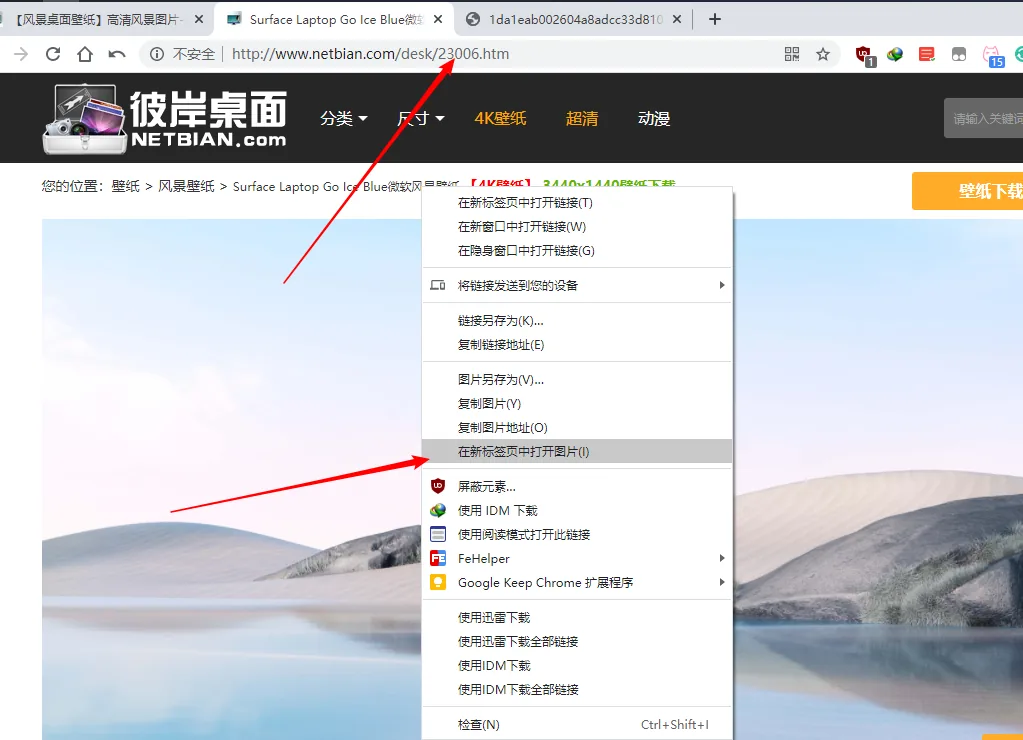
确定爬取流程
2.1 风景分类界面获取介绍图片代号
2.2 图片介绍界面获取图片真实地址
三、写脚本
以下为获取风景下图片链接的bash脚本,第一页的图片请单独处理。
#!/bin/bash
# 以下代码只处理第2-203页,第一页的图片请自行处理
# 定义种类kind为fengjing
kind=fengjing
# 定义页码page为2 3 .. 203
for page in $(seq 2 203)
do
	# 拼接种类页面链接kind_link
	kind_link="http://www.netbian.com/$kind/index_$page.htm"
	# 获取该页所有图片编号pic_num_list
	pic_num_list=$(wget -qO- $kind_link | grep -aoP "(?<=href=\"/desk/).*?(?=.htm)")
	# 定义图片编号pic_num
	for pic_num in $pic_num_list
	do
		# 拼接图片信息页面链接pic_info_link
        pic_info_link=http://www.netbian.com/desk/$pic_num.htm
        # 获取图片地址pic_link
        pic_link=$(wget -qO- $pic_info_link | grep -aoP -m 1 "http://img.netbian.com/file/20.*jpg(?=\" alt)")
        # 打印图片地址
        echo $pic_link
        # 保存图片地址到文件
        echo $pic_link >> ${kind}_down.txt
    done
done
注意
grep -a可以查找二进制中的文字grep -m 1只保留第一次匹配- 用
wget -qO-而不用curl -s的原因是之后的grep -m 1查找到之后会堵塞通道造成错误
四、下载图片
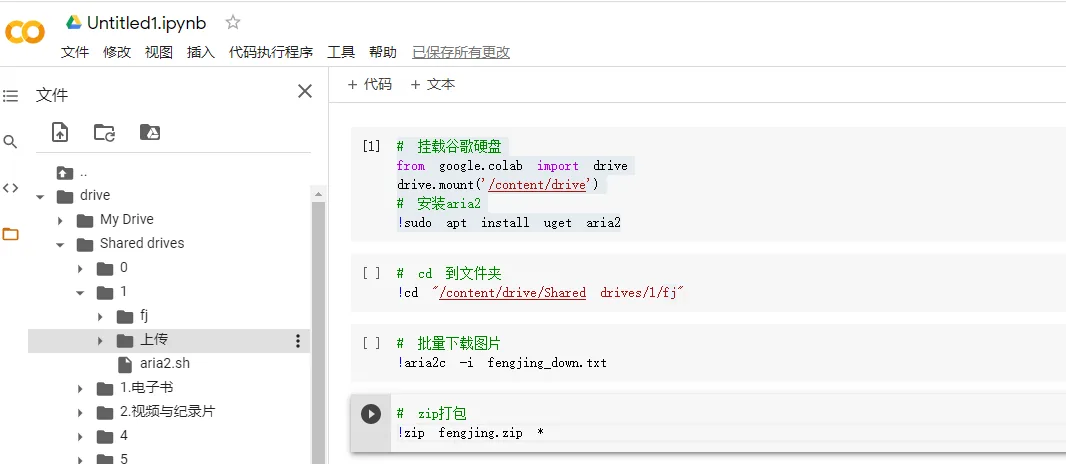
因为完全下载所需的空间需要几G之上,我的VPS不足以持,因此就用到了Google家的COLAB
注意
COLAB中!开头表示运行SHELL命令
# 挂载谷歌硬盘
from google.colab import drive
drive.mount('/content/drive')
# 安装aria2
!sudo apt install uget aria2

# cd 到文件夹
!cd "/content/drive/Shared drives/1/fj"

!aria2c -i fengjing_down.txt

!zip fengjing.zip *
五、成品及反思
此次抓取中,有几点需要注意,
- 下载网页源码之后可以找到文字,但用
grep找不到,就是二进制文件的问题,加参数-a即可。 grep找到多个匹配,加参数-m即可只保留第一个。curl和grep连用有时会导致通道堵塞,使用wget -qO-全下载之后再grep即可。COLAB中使用shell命令极大的增加了能力,并且可以挂载谷歌网盘,极大得方便文件的传输。